m浏览器官方手机版是一款界面清爽、操作简洁且没有弹窗广告的浏览器,整体功能便捷实用,并开放多种可扩展能力,用户能按需挑选想要的功能进行添加,从而打造属于自己的手机浏览器。软件内置功能相当丰富,涵盖视频播放、手势按钮、电视投屏、油猴脚本、广告拦截、书签同步等,让用户获得高效又便捷的上网体验。
除这些基础功能外,这款软件还具备超级聚合搜索、DLNA电视投屏、审查元素、多内核浏览器切换、m3u8视频下载等特色能力,使用户可以享受更便捷、更贴合个人需求的浏览器体验。
另外,m浏览器官方手机版还强化了搜索能力,突破传统搜索的设计思路;多页面独立进程方案能避免搜索时出现数据混乱。其多引擎框架既能灵活整合各类网页数据,也支持编写爬虫脚本,进一步挖掘和采集数据,让用户轻松在本地建立专属数据库。
软件亮点
1、超级聚合搜索,支持多引擎与多爬虫,自定义简单,极客用户必备。
2、可在APP内直接开发轻站小程序,零基础也能上手。
3、支持下载m3u8视频
4、具备审查元素能力,并可任意修改网页内容
5、支持悬浮播放器与长按倍速
6、支持DLNA电视投屏
7、支持长按快速搜索、选中文字翻译及全局翻译
8、支持强大的ADB广告过滤插件
9、兼容油猴脚本功能
10、可将 IDM、ADM 等第三方下载器设为默认浏览器
11、支持多内核浏览器切换
12、创新隐藏手势操作,大屏时代单手也能自如操控
如何操作m浏览器轻站
先说明一下,轻站并不是网站,而是一个精简版的小程序框架;它的视图通过安卓底层进行渲染,并不依赖 WebView(浏览框),所以轻站和网站其实没有直接关系。
现阶段,轻站的设计更偏向后端开发者做 API 调试。后续版本中,轻站会朝原型设计方向完善,方便产品或原型人员在交给客户端开发工程师前,先确定原型的交互功能,从而减少因 UI 或参数调整而频繁重构客户端代码。毕竟开发过程中,修改和调试代码往往比初次编写更费时间。
另一方面,作为极客型 APP,轻站框架也能用于数据整合,带来更高效的数据预览。但请勿借此进行违法操作。为方便小团队交流,编写好的轻站功能允许以扩展形式导出使用。为避免有人利用可导出特性进行非法交易,软件不提供加密功能,也无法加密(口令导出的内容经过压缩,看起来像乱码,实际没有加密),请理解。
轻站本身不提供任何数据内容,也不负责内容审核或限制。因此使用相关功能时,风险需由你自行承担;若无法接受,请不要使用该功能。
1、新建轻站或编辑已有引擎
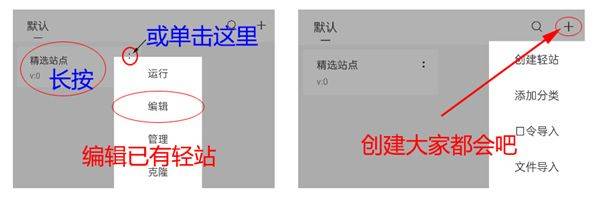
2、轻站框架的构成
轻站由属性、模块、接口、常量、资源 五个部分组成,其中模块是核心。
属性:轻站的相关信息。
模块就是页面。一个页面可以只包含一个模块,也能由多个模块嵌套组成。例如普通列表只需一个列表模块;若想在列表顶部加入幻灯片,就需要再创建一个幻灯片模块,并将其嵌套到列表中。若想嵌入更多模块让界面更丰富,则可使用面板模块;面板模块能同时容纳多个不同类型的模块,实现多样的视觉效果。
接口是软件打开轻站的一个入口。首页指在轻站列表中点击后默认打开的页面,搜索则是搜索该轻站时展示的页面。
常量是固定值,在模块运行时可通过获取变量的方式取得。
资源用于存放本地资源,如 JS 文件、图片文件等,供模块调用;目前尚未开放,这里暂不展开。
3、模块说明
理论不如实操,这里以幻灯片模块为例,如图所示: 初次接触轻站的朋友,请新建一个窗口并创建一个轻站,按图中步骤操作。跟着做一遍,基本就能掌握轻站写法了。
数据源值:
百度#baidu.com#http://nr19.cn/p/baidu.jpg
搜狗#sogou.com#http://nr19.cn/p/sogou.jpg
谷歌#google.com#http://nr19.cn/p/google.jpg
视图数据值:(长按检索工具可一键导入)
表项=.fg()
标题=.tz(#)
地址=.ty(#)。tz(#)
图片=.ty2(#)
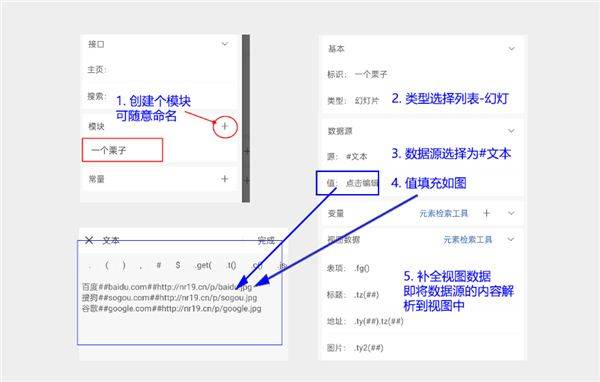
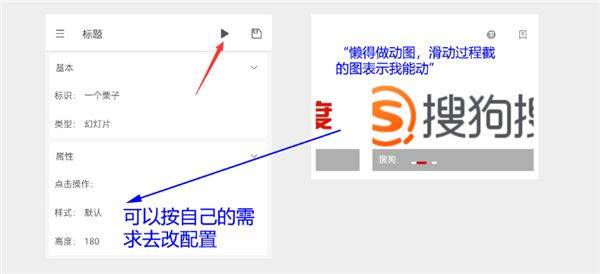
完成上述步骤,一个页面就完成了,是不是很简单?
数据源就是视图的原始内容。可用 #爬虫 获取网络或本地文本内容,如 API、网页等;也能像上面例子那样,用 #文本 放入固定文本。嗯,先看一下轻站的运行流程图:
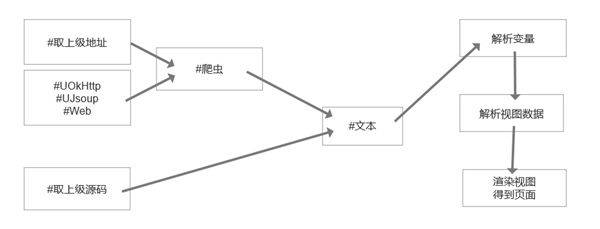
如图所示,无论数据源处理哪种类型,最终目的都是取得文本,再交给页面渲染器解析并渲染界面。顺便说下,数据源里的 #爬虫 与通常说的爬虫关系不大,但也并非毫无关联。爬虫配置图解:
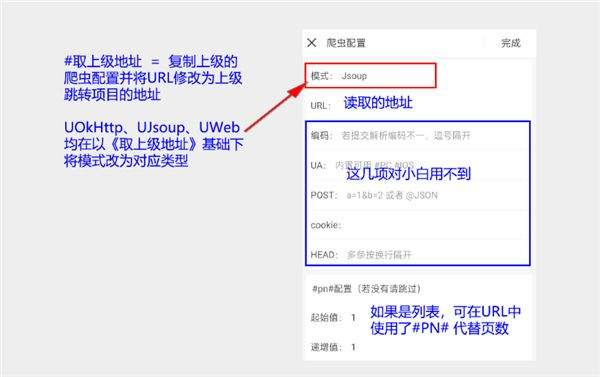
解析器使用 E2 表达式(这是为开发本软件而原创的新功能),详细解析函数可查看文章:E2表达式函数大全。根据上述运行流程图,会先解析“变量”数据;其实视图数据中的就是变量,只是自定义变量会优先解析。E2 允许读取变量,而模块中加入变量,是为了避免视图数据同一行内 E2 难以完成复杂解析。通常情况下无需自定义变量。
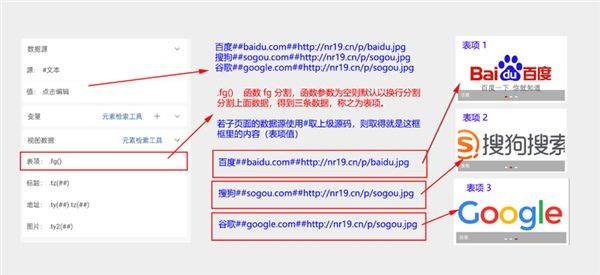
到这里,轻站功能开发就介绍完了。相信你已经理解轻站的原理,是不是特别简单。
操作教程
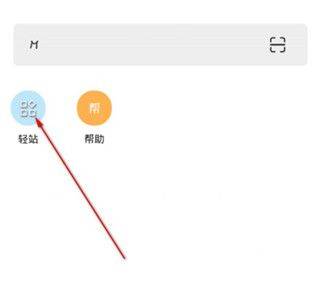
1、打开从本站下载的M浏览器。第一步,进入软件首页,点击轻站按钮。
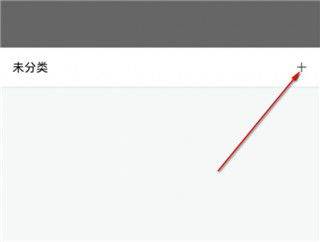
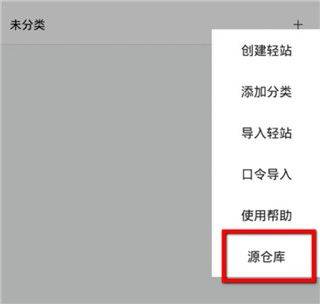
2、第二步,点击右上角的“+”号。
3、第三步,点击源仓库。
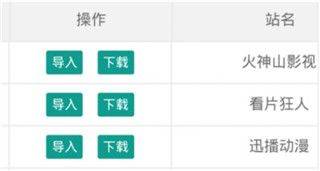
4、进入下方界面后,就可以挑选自己需要的源,找到后点击导入即可。
E2表达式函数汇总
E2表达式主要用在M浏览器的爬虫功能中,若打算自行编写脚本,就需要先对它有所了解。
E2 表达式
它是一类处理文本的表达式。比如想取得"文本"前面的几个字,可以用 .tz(文本) 拿到 "用于处理" 四个字。E2 函数名以中文拼音首字母来命名,即便没有开发基础也能较轻松地操作。
E2 还支持数组操作。在M浏览器中,轻站或虫子获取列表时会用到数组。为了方便理解与使用,文本处理函数一般以 t 开头,例如取文本左边的 tz,t 指文本,z 是“左”的拼音首字母,由此也能知道取文本右边函数是 ty 。数组处理函数以 i 开头,如 .ij(aaa) ,j 代表“加”,也就是向数据里加入一行值为 aaa 的数组。
以下函数仅 2.3.5 及以上版本可用
文本操作类:
.tz() .ty() 用于获取文本左侧、右侧的数据。
.tz2() .ty2() 从后往前读取判断值文本,并取判断值左、右(前、后)的数据。若内容为 abbacc ,使用 .ty(a) 得到 bbacc,使用 .ty2(a) 得到 cc。
.t() 用于删除 HTML 标识,无需提供参数。例如内容为
a
b
时,去掉 html 代码提取正文,直接使用 .t() 即可,最终得到 ab
.tj() 用于添加内容。若已有 ab,想得到 abcd: .tj(cd)
.tzc() 参数为数字,如 tzc(5)。如果当前操作值字数大于 5,就取前 5 个字;少于则全部取出。所以这里 zc 可理解为“最长”。若操作值为 ABCDE ,使用 .tzc(3) 得到 AB
.tsk() 无参数,用于去除首尾空格。qswk 再加 t 太长不好记,就取“首空”之意,也就是去掉操作内容首尾的空格字符
.th() 替换。参数为 欲被替换文本#替换文本。若内容为 ABC,想把 B 改成 2,可用 .th(B#2)。若要将其置空,可直接用 .th(B),得到 AB。另外,th 中欲被替换文本支持正则表达式;如果要替换的内容与正则通配符冲突,就需要写转义。例如内容 111ADGDGS333,把中间英文字母换成 333,可用 .th([A-Z]+#333) 。若不清楚哪些是正则匹配符,建议使用 .th2() ,不同之处是 th2 中欲被替换文本不支持正则匹配。
.tx() x 表示“新”,数组部分也有类似函数。M浏览器扩展使用E2时,通常要先定义源内容,例如数据源爬虫就是读取到的网络内容,文本就是定义的文本。这里假设源内容是 xByyEzz ,需要获取 E 后面的值和 B 前面的值(其中 x、y、z 会动态变化),也就是 E 后面 + B 前面。“新”的概念就是保留之前操作的值不变,让后续函数处理源内容。理解后就能操作,分三步:先取 E 后面值 ty2(E) -> 再存储并把当前操作内容定义为源内容 tx() -> 最后取 B 前面值 .tz(B)。
快速梳理一遍:源内容 xByyEzz 在使用 E2 时会自动转为操作值,接着用 ty2(E),取 E 后面就是把操作值置为 zz;再用 .tx() 存储操作值,并把操作值设为源文本 xByyEzz;随后用 tz(B) 得到 x 。后面没有函数了,就把前面存储的值和操作值输出,最终得到 xyyzz 。
加解密操作:
.en() 加密 .dn() 解密
.en(base64) / .dn(base64) ----- base64 加密与解密
.en(md5) --- 获取MD5
.en/dn(utf-8/gbk等编码值) --- URL编码与解码
aes des 3des 加解密。注意参数之间用小写逗号分隔,输出类型仅两种:hex(16进制)及 base64
.en/dn (aes,模式,密码,编码,输出类型,偏移量)
数组操作类:
.i(正数) 获取数组中的内容,从0开始。如取第一个值用 .i(0),第三个值用 .i(2),以此类推
.i(负数) 从数组尾部开始查找,-1 指数组倒数第一个值,-2 指倒数第二个值,以此类推
.i(数,数) 取数组范围。理解正负数用法后,这里的数可自由填正数或负数,怎么方便判断就怎么来。若有数组 [ab,ac,ad,ae],要获取 ac,ad,ae,即排除第一个: .i(1,-1) ;排除最后一个: .i(0,-2)
.ij(添加的文本) 把"添加的文本"加入数组。例如数组已有 [aa,bb,cc] ,操作后等于 [aa,bb,cc,添加的文本]
.ix() 存储数组。之后与 tx 类似,把操作值改为原文本。注意数组操作后可继续操作其他函数
.it(分割符) 在E2里,i 表示数组,t 表示文本。它将数组合并为文本,中间用参数分隔符填充;若不填参数则没有分隔符
正则表达式
.z() 参数中若含括号,必须添加转义供E2识别。若正则表达式中括号较多,在E2里看起来比较费眼,可在参数前后添加两个@表示内容为参数。比如正则为 (a\(b\)c)|(x\(y\)z) ,即匹配 a(b)c 或 x(y) z。在E2里必须给括号再添加一个转义符 \,即 .z(\(a\\(b\\)c\)|\(x\\(y\\)z\)) ,这样看起来很乱;如果在参数两则加双@,就可写成 .z((a\(b\)c)|(x\(y\)z)),看起来会相对和谐。
.z2() 匹配子表达式,写法同上。子表达式就是正则中()里的值,匹配后可用 .i() 获取指定括号内容。
CSS选择器
.css(选择器语法) 返回匹配得到的数组
.a(属性名) 返回属性值,如 a 标签的 href 属性(跳转地址): .a(href) 。 img标签的图片属性src(图片地址):。a(src)
XML解析器
.xml(标签名) 和 .css 用法一致
JSON解析器
.json(参数名) 无论普通对象还是数组对象,都使用这个命令。数组对象返回数组、文本对象返回文本(也可以将其视为只有一个子项的数组)。
更新记录
v3.3.16.0920版本
修复部分小错误,提升整体稳定性。
评论